 智慧云天
首页 / 技术服务 / 使用普通摄像头的无感人脸识别考勤系统的技术剖析:FFmpeg硬解码与软解码
技术服务
使用普通摄像头的无感人脸识别考勤系统的技术剖析:FFmpeg硬解码与软解码
在基于普通 IP 摄像头的无感人脸识别系统中,FFmpeg 承担的是“把 RTSP 码流还原为像素帧”的职责,解码器输出的帧随后才进入人脸检测与特征比对模型。这个位置决定了 FFmpeg 解码面临一个核心矛盾:解码要快,但下游算法要“拿得到”帧。软解码由 CPU 完成 H.264/H.265 的熵解码、反量化、运动补偿与环路滤波,计算负担完全压在通用计算单元上;硬解码则将大部分比特流重建工作交给 GPU 或 SoC 中的专用视频解码引擎,从而把 CPU 解放出来留给业务逻辑。然而,硬解码的输出往往驻留在 GPU 显存或硬件表面中,而典型的人脸检测模型运行在 CPU 或另一块计算设备上,二者之间存在明确的内存边界。理解硬解码与软解码的差异,本质上是在理解“计算放在哪里”和“数据放在哪里”这两个相互纠缠的问题。
1. 引言:解码环节在无感人脸识别流水线中的位置与矛盾
在基于普通 IP 摄像头的无感人脸识别系统中,FFmpeg 承担的是“把 RTSP 码流还原为像素帧”的职责,解码器输出的帧随后才进入人脸检测与特征比对模型。这个位置决定了 FFmpeg 解码面临一个核心矛盾:解码要快,但下游算法要“拿得到”帧。软解码由 CPU 完成 H.264/H.265 的熵解码、反量化、运动补偿与环路滤波,计算负担完全压在通用计算单元上;硬解码则将大部分比特流重建工作交给 GPU 或 SoC 中的专用视频解码引擎,从而把 CPU 解放出来留给业务逻辑。然而,硬解码的输出往往驻留在 GPU 显存或硬件表面中,而典型的人脸检测模型运行在 CPU 或另一块计算设备上,二者之间存在明确的内存边界。理解硬解码与软解码的差异,本质上是在理解“计算放在哪里”和“数据放在哪里”这两个相互纠缠的问题。
2. 软解码:控制力与兼容性的基线
FFmpeg 的软解码路径由纯软件实现的解码器完成,如 H.264 的 h264 解码器和 HEVC 的 hevc 解码器。它的全部处理都在系统内存中进行,解码输出的 AVFrame 直接持有可由 CPU 访问的像素数据(通常是 yuv420p 或 yuv420p10le 等格式)。这条路径的突出优势在于格式支持的完整性和行为的可预测性:无论视频是 8-bit 还是 10-bit,是 4:2:0 还是 4:2:2、4:4:4,软解码器通常都能正确重建;它不依赖特定厂商的驱动,也不受硬件解码单元在 profile 和 bit depth 上的功能裁剪影响。
代价是 CPU 占用。在 1080p H.264 场景下,软解码已经会让一颗移动级 CPU 的平均占用达到 85% 左右;到了 4K HEVC,软解码的 CPU 占用逼近 98%,并伴随明显掉帧。对于一台需要同时处理多路 RTSP 摄像头的人脸识别服务器而言,如果每一路都走软解码,CPU 在进入人脸检测之前就已经被视频解码耗尽,检测模型再轻量也无法获得足够的算力预算。
3. 硬解码:API 光谱与 FFmpeg 的接入方式
FFmpeg 的硬解码支持横跨多个平台和 API。在 NVIDIA 平台上,h264_cuvid/hevc_cuvid 是通过 CUVID 接口调用 NVDEC 独立解码引擎的外部封装解码器;Intel 平台依赖 QSV(Quick Sync Video)或 Linux 下的 VAAPI;Apple 生态使用 VideoToolbox;Windows 上则有 D3D11VA/DXVA2 等路径。从 FFmpeg 的使用方式看,硬解码可分为两类:一类是 内部 hwaccel 解码器,通过 -hwaccel cuda、-hwaccel vaapi 等选项启用,软件解码器先启动,检测到流可硬解后将主要处理委托给硬件,若硬解不支持则自动回退软解;另一类是外部封装解码器,如 -c:v h264_cuvid,它要求码流类型在事先已知,且不具备自动回退能力。对于人脸识别系统这类需要稳定处理多品牌 IP 摄像头的场景,内部 hwaccel 路径的自动回退特性通常比外部封装解码器更安全,因为摄像头输出的码流参数并不总是完全可控。
硬解码的性能收益是量级上的。在 1080p H.264 解码中,VAAPI 硬解可将平均 CPU 占用从 85% 压到 12%,整机功耗降低约一半;在 4K HEVC 上,软解码 CPU 占用 98% 且卡顿,硬解仅 15% 且保持流畅。在多路 RTSP 场景中,软解码 4 路 1080P 就可能占用 i7 约 80% 的 CPU,而硬解可将这一占用压到 5% 左右。对于无感人脸识别系统,这意味着原本被视频解码占据的 CPU 核心可以被释放给人脸检测、特征提取和比对任务,或者在同等硬件上处理更多路摄像头。
4. 关键分水岭:解码帧“在哪儿”决定了后端的架构
硬解码的性能数字容易让人忽略一个同样重要的问题:硬解输出的帧默认在 GPU 上。NVDEC 的输出位于显存中的硬件表面,VAAPI 的输出位于 DRM 缓冲区,QSV 的输出位于核显可访问的硬件表面。FFmpeg 通过 AVFrame 的 format 字段将这种帧标记为硬件像素格式(如 AV_PIX_FMT_CUDA、AV_PIX_FMT_VAAPI),data 指针指向的并非可直接由 CPU 读取的系统内存地址。
这对人脸识别流水线有直接后果。典型的人脸检测模型(无论是基于 OpenCV DNN、ONNX Runtime 还是 TensorRT)接受的输入是主机内存中的 BGR 或 RGB 张量,或者是特定设备上的张量。如果硬解码的输出停留在 GPU 显存中,而检测器运行在 CPU 上,就必须进行一次 GPU → 系统内存的下载拷贝。FFmpeg 提供了 hwdownload 滤镜来完成这一步,但 PCIe 传输本身会引入延迟和带宽开销。更隐蔽的问题是,如果使用 -hwaccel cuda 却没有显式设置 -hwaccel_output_format cuda,FFmpeg 会在解码后静默地将帧回拷到系统内存,表面上看仍然在用硬解,实际上吞吐量可能损失高达 50%,因为每一帧都经历了一次不必要的 GPU→CPU 往返。
反过来,如果下游的人脸检测模型本身就运行在 GPU 上(例如 TensorRT 引擎或 CUDA 加速的推理后端),正确的做法是让解码帧保持在 GPU 显存中,通过 -hwaccel_output_format cuda 配合 scale_cuda 等 GPU 侧滤镜完成预处理,再以零拷贝或设备指针的方式直接交给检测器,从而完全绕开系统内存。此时硬解码才真正兑现了“全 GPU 流水线”的性能承诺。因此,硬解码的选型不能脱离下游算法的部署位置来谈:检测器在 CPU 上,硬解的主要价值是释放 CPU 负载,但需要接受回拷开销;检测器在 GPU 上,硬解才能真正实现端到端的零拷贝加速。
5. 面向人脸识别场景的工程选型与配置
基于上述分析,可以给出几条具体的工程判断。
第一,优先使用内部 hwaccel 路径并显式管理输出格式。对于多路 RTSP 人脸识别系统,摄像头型号和码流参数往往不完全统一,外部封装解码器(h264_cuvid)在遇到不支持的 profile 时会直接失败,而内部 -hwaccel 路径在硬解不可用时可回退软解,更适合长期运行的无人值守场景。同时,必须根据下游算法所在位置显式设置 -hwaccel_output_format:下游在 CPU 上时,不设置该选项(让 FFmpeg 自动回拷)或使用 hwdownload;下游在 GPU 上时,设置为对应后端(cuda、vaapi、qsv)以避免隐式拷贝。
第二,不要忽视硬解码的格式功能裁剪。硬件解码器对 H.264 通常止步于 8-bit 4:2:0,对 HEVC 的 10-bit 和 4:2:2 支持也因代际而异。如果某路摄像头输出的是 10-bit HEVC 或 4:2:2 信号,而硬解单元不支持,FFmpeg 可能回退软解,或者在某些配置下产生不正确的色彩转换。在人脸识别场景中,色彩空间错误会直接影响肤色区域的检测可靠性。上线前应当用实际摄像头码流对目标硬解后端做码流级验证,而不是仅凭编解码器名称判断“支持”。
第三,软解码不应被完全抛弃。软解码在单路或低分辨率场景下依然是最可预测的选择,并且在硬解驱动异常、容器环境缺少设备直通、或硬件解码器对特定码流行为异常时,软解码是唯一的兜底路径。一种务实的架构是:默认启用 -hwaccel auto 或厂商对应的 hwaccel,同时保留软解作为自动回退;在监控中跟踪回退发生的频率和原因,而不是假设硬解总是成功。
第四,编译与驱动是硬解可用性的前置条件。通过发行版包管理器安装的 FFmpeg 通常不包含 NVIDIA 的 NVDEC/NVENC 支持或某些 SoC 的私有硬解模块,需要从源码以 --enable-cuvid --enable-nvenc 等选项重新编译,或使用芯片厂商提供的 FFmpeg 构建。这一环节的缺失会让“硬解”配置在运行时静默退回软解,而 CPU 占用数据会暴露这一事实——如果硬解配置后 CPU 占用没有出现数量级的下降,首先应检查 FFmpeg 的编译选项和驱动加载状态,而不是怀疑参数本身。
6. 结语
FFmpeg 的硬解码与软解码不是简单的“快与慢”二选一,而是计算位置与数据位置的双重权衡。软解码把计算放在 CPU 上,换来的是对帧数据的完全掌控和格式兼容性;硬解码把计算卸载到专用引擎,代价是帧可能被困在设备内存中,需要根据下游算法的部署位置做出回拷或零拷贝的架构决策。对于无感人脸识别系统,硬解码在降低 CPU 负载和支撑多路 RTSP 方面的收益是决定性的,但只有当解码输出的“位置”与人脸检测器所需的“位置”被显式对齐时,这份收益才不会在隐式的内存往返中被抵消。理解这一点,比记住任何一条 -hwaccel 命令都更重要。
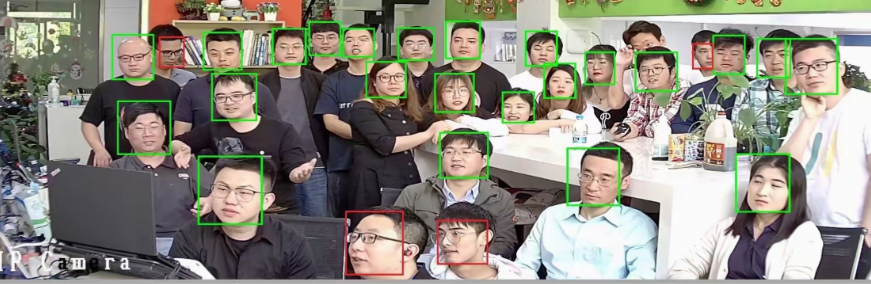
智慧云天的基于普通网络摄像头的无感考勤点名系统,一般建议使用带有NVIDIA显卡的电脑,这样使用硬解码,让检测、识别速度更快,并且支持同一个视频画面同时识别15人。
常见问题
硬解码一定比软解码快吗?为什么配置硬解后 CPU 占用没有明显下降?
不一定。硬解码的优势是把解码计算从 CPU 卸载到 GPU/专用引擎,但如果配置后帧被隐式回拷到系统内存,或者 FFmpeg 实际回退到了软解,CPU 占用就不会明显下降。常见原因包括:FFmpeg 编译时未启用对应硬解模块、驱动未正确加载、码流 profile/bit depth 不被硬解支持、使用了 -hwaccel cuda 但未设置 -hwaccel_output_format cuda 导致隐式回拷。应先用 ffmpeg -hwaccels、日志和 CPU 占用对比确认硬解是否真正生效。
人脸检测在 CPU 上运行,硬解码后必须用 hwdownload 吗?如何减少拷贝开销?
如果硬解输出停留在 GPU 显存,而检测器在 CPU 上,就必须通过 hwdownload 或 FFmpeg 自动回拷把帧下载到系统内存,否则 CPU 无法直接读取。减少开销的方式包括:降低分辨率/帧率、只对感兴趣帧做检测、批量处理、使用更高效的 PCIe 传输路径,或者把检测模型也迁移到 GPU 上,让解码和检测在同一设备内完成,避免 GPU→CPU 往返。
多路 RTSP 人脸识别系统应该选 h264_cuvid 还是 -hwaccel cuda?
优先考虑 -hwaccel cuda 这类内部 hwaccel 路径。它对多品牌摄像头更友好,硬解不支持时可自动回退软解,适合长期无人值守运行。h264_cuvid 属于外部封装解码器,要求码流类型已知且不支持自动回退,遇到不支持的 profile 会直接失败。若码流完全可控且追求特定路径,可以评估 h264_cuvid,但生产环境通常更推荐内部 hwaccel 加回退策略。
摄像头输出 10-bit HEVC 或 4:2:2,硬解不支持怎么办?
首先用实际摄像头码流验证目标硬解后端的 profile、bit depth 和色度采样支持情况。若不支持,应让 FFmpeg 回退软解,或转码为硬解支持的格式;同时检查色彩转换是否正确,避免肤色区域检测受影响。上线前应做码流级验证,而不是只看编解码器名称。
如何验证 FFmpeg 硬解码是否真正生效?
可以从四个层面验证:① 查看 FFmpeg 日志中是否出现 Using hardware decoding 或对应 hwaccel 信息;② 用 ffmpeg -hwaccels 确认编译支持的硬解后端;③ 对比硬解配置前后的 CPU 占用、GPU 利用率和吞吐量;④ 检查输出 AVFrame 的 format 是否为 AV_PIX_FMT_CUDA、AV_PIX_FMT_VAAPI 等硬件像素格式。若 CPU 占用没有数量级下降,优先排查编译选项、驱动和隐式回拷。