 智慧云天
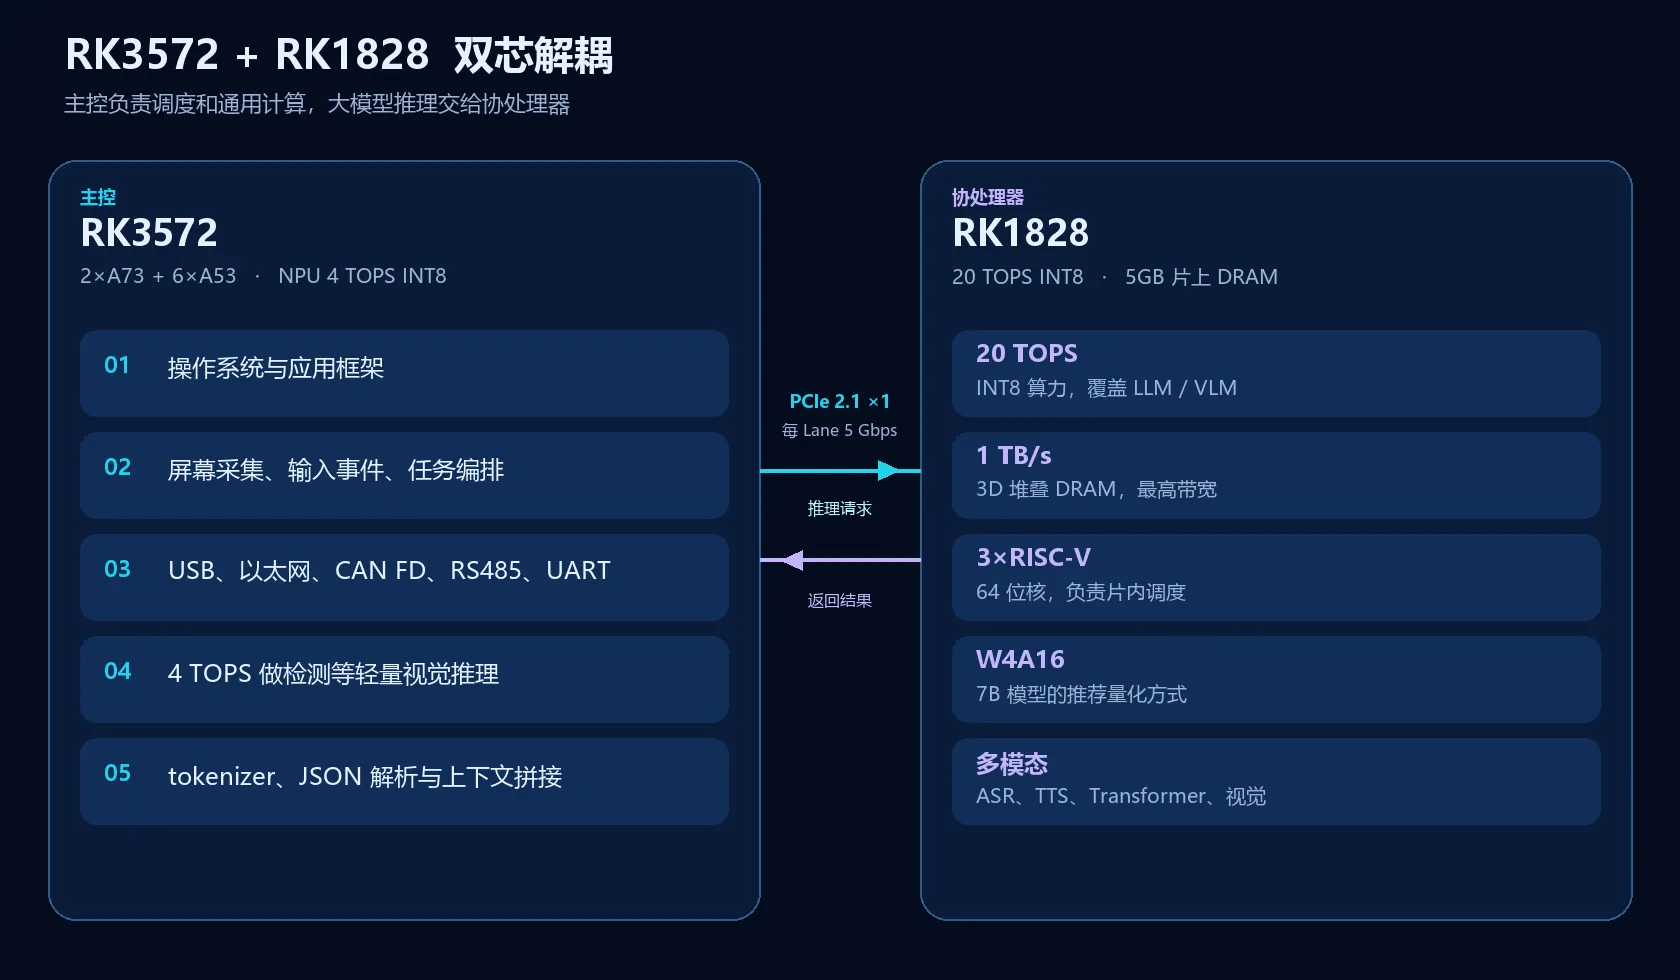
端侧智能体要持续跑大语言模型,还要保住屏幕、外设和工具调用的响应。RK3572 的 4 TOPS 扛不住 7B 级推理。瑞芯微的做法是把主控和专用协处理器拆开:RK3572 做调度,RK1828 做推理。
一、架构提出背景:端侧智能体为何需要双芯解耦
端侧 AI 智能体对硬件的要求和传统单次推理不一样。智能体要持续运行大语言模型做多轮对话,同时维护 KV Cache,并处理工具调用的上下文拼接和 I/O。瓶颈不只是算力峰值,而是内存带宽和算力能不能持续供给。
4 TOPS 的上限
RK3572 内置 NPU 为 4 TOPS(INT8)。目标检测、图像分类够用,但难以支撑 7B 级模型的可用推理速度。
主控不能被推理占满
主控还要跑系统、采屏、编排任务、控外设。LLM 若占住主控的 NPU 和内存带宽,系统响应和推理质量会互相挤压。
算力解耦是把主控 SoC 和专用 AI 协处理器在物理层、任务层分开。主控只做调度和通用计算,LLM 推理全部交给协处理器。RK1828 就是按这个架构设计的端侧 AI 协处理器。
二、RK1828 协处理器技术规格
2.1 核心架构:3D 堆叠 DRAM 突破内存墙
RK1828 是瑞芯微 RK182X 系列的旗舰型号,2025 年 7 月全球首发,2026 年量产。它把 5GB 高带宽 DRAM 直接做进封装,内存带宽最高 1 TB/s。
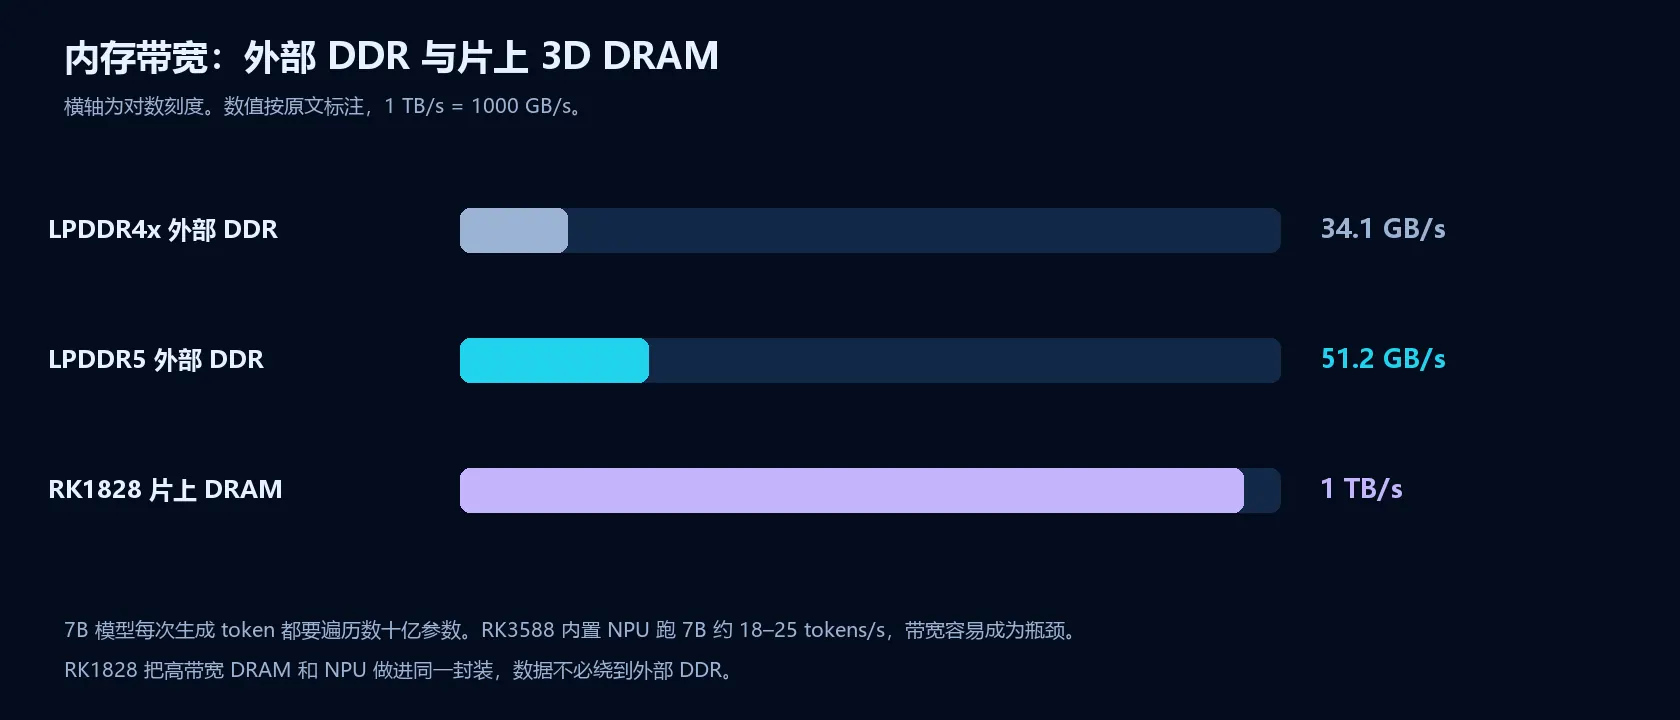
传统方案的模型权重要从外部 DDR 读。LPDDR4x 理论带宽约 34.1 GB/s,LPDDR5 约 51.2 GB/s。7B 模型每生成一个 token 都要遍历数十亿参数,外部 DDR 不够用。以 RK3588 内置 NPU 跑 7B 为例,推理速度约 18–25 tokens/s,多任务时容易卡。RK1828 把 1 TB/s 带宽的 DRAM 和 NPU 放在同一封装里,绕开这条路径,数据访问延迟会低很多。
2.2 NPU 算力与精度
| 项目 | RK1828 |
|---|---|
| NPU | 20 TOPS(INT8) |
| 精度 | INT4、INT8、INT16、FP8、FP16、BF16 |
| 片内处理器 | 3 核 RISC-V 64 位,负责协处理器内部调度 |
| 片上 DRAM | 5GB,带宽最高 1 TB/s |
| 7B 推荐量化 | W4A16(4bit 权重、16bit 激活) |
| INT8 的 7B | 超出 5GB,需要权重分片,速度明显下降 |
混合精度决定 7B 能不能放进 5GB。W4A16 是容量和精度之间比较稳的配法。INT8 量化的 7B 会越过 5GB 边界。
2.3 硬件形态与接口
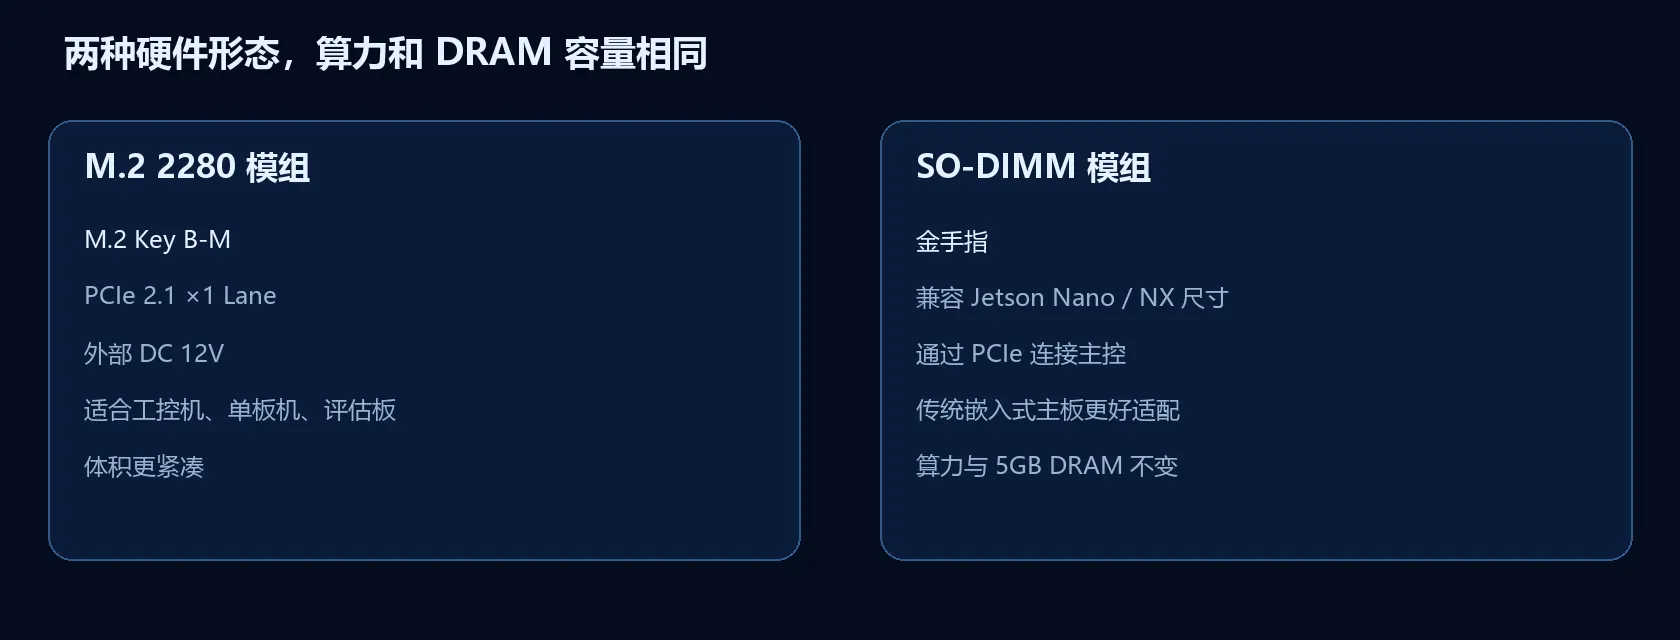
- M.2 2280 模组:M.2 Key B-M,经 PCIe 2.1 ×1 Lane 与主控通信,外部 DC 12V。适合带 M.2 Key 插槽的工控机、单板机和评估板,体积更紧凑。
- SO-DIMM 模组:金手指,兼容 Jetson Nano/NX 尺寸,经 PCIe 连接主控。传统嵌入式主板上更好接。
2.4 功耗与散热
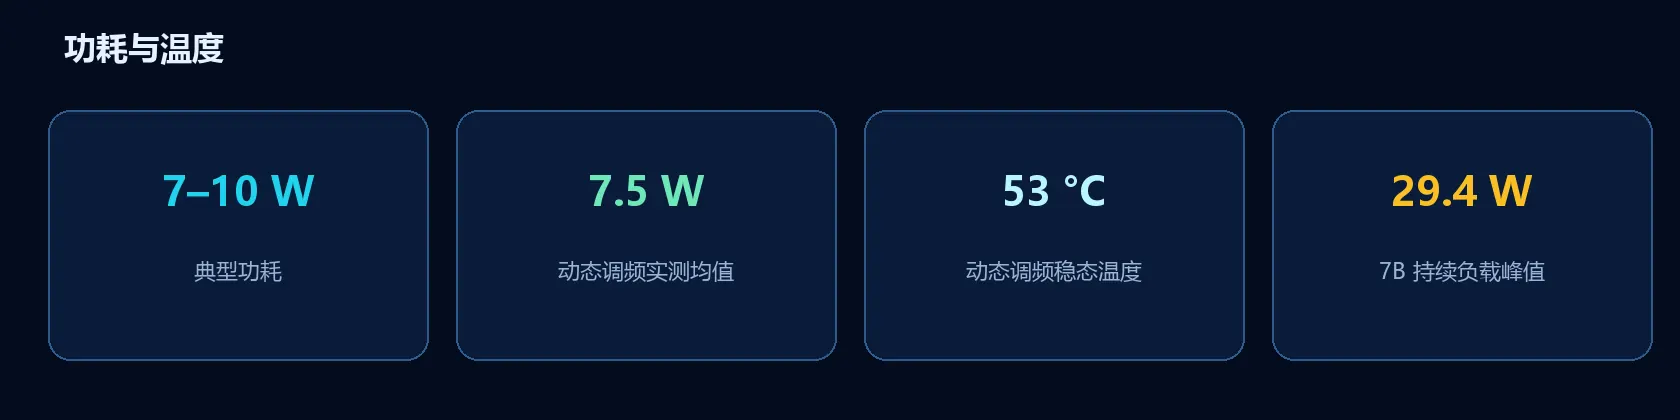
典型功耗约 7–10W。7B 模型持续负载下峰值约 29.4W。ondemand 动态调频的实测平均功耗约 7.5W,稳态温度约 53°C。基础运行可以被动散热;持续高负载建议加小风扇。无风扇边缘设备的热设计裕量是够的,长时间满载仍要留风道。
三、RK3572 作为主控的适配性
3.1 接口
RK3572 有三路 PCIe 2.1 控制器,每 Lane 最高 5 Gbps,并集成 SATA 3.1、USB 3.0、双千兆以太网和 DSMC。PCIe 2.1 是它和 RK1828 建立数据通道的基础。
在 RKNN3 SDK 里,RK3572 可以不接协处理器,自己做推理平台;也可以经 PCIe 连接 RK1828,进入协处理器模式。两条路径在 SDK 里是分开配置的。
3.2 任务怎么分
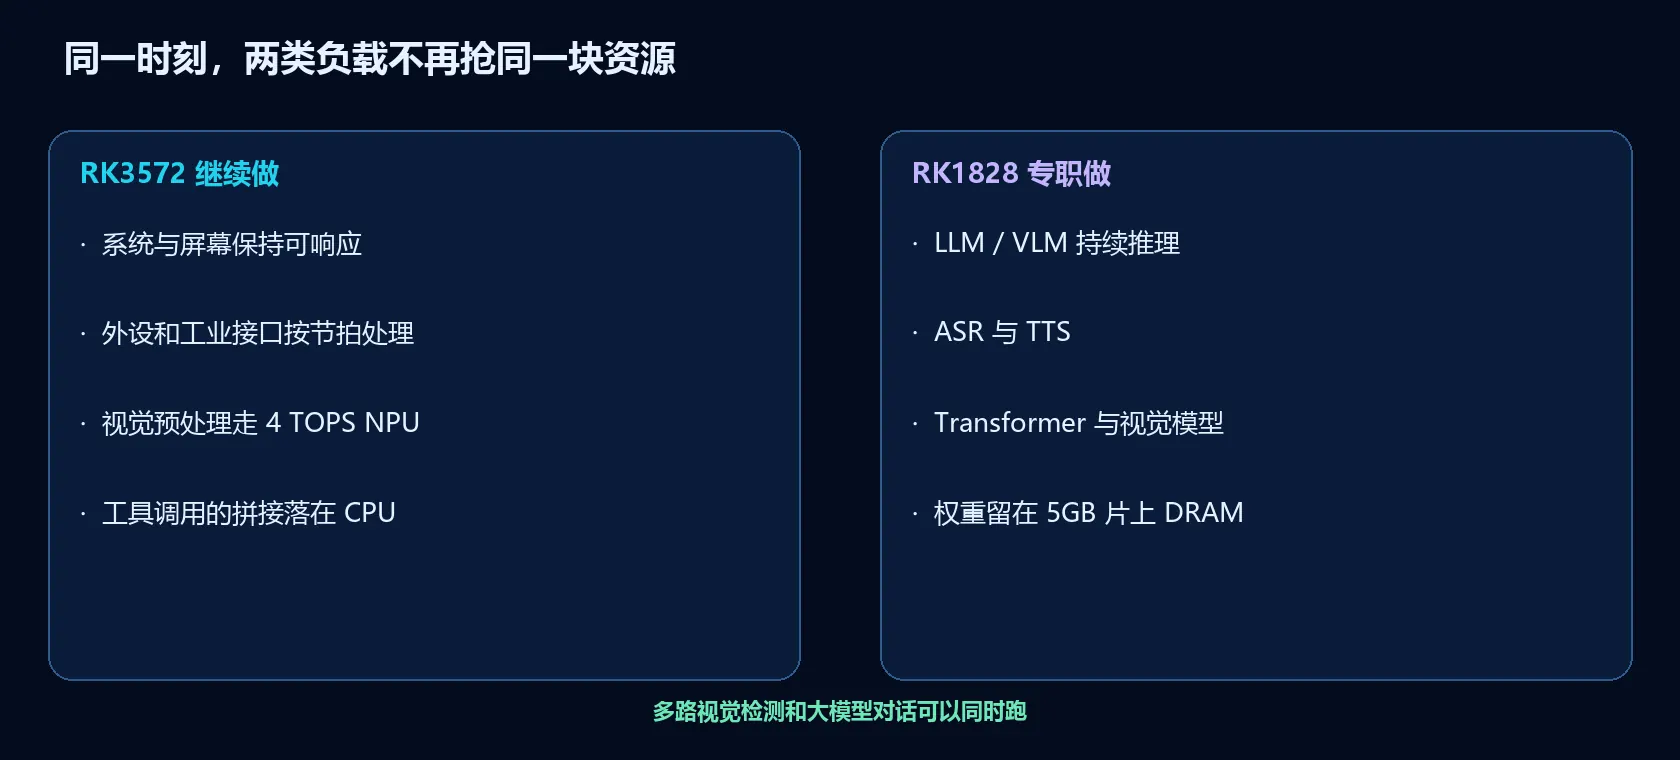
RK3572 在这套架构里的角色,和 RK3576、RK3588 当主控时一样:
- 系统运行:Android 或 Linux、应用框架、文件系统
- 屏幕采集与任务编排:采屏、输入事件、工作流调度
- 外设:USB、以太网、CAN FD、RS485、UART
- 轻量 AI:4 TOPS 做目标检测、人脸检测和轻量模型
- 前后处理:图像归一化、tokenizer、工具调用的 JSON 和上下文拼接
RK1828 专职做 LLM/VLM、ASR、TTS、Transformer 和视觉模型这类算得重的任务。单芯片方案里,LLM 会一直占着 NPU 和内存带宽,采屏、编解码和外设就会抖。拆开以后,两套资源池互不占用。
3.3 和 RK3576、RK3588 主控方案的差别
RK3576 自带 6 TOPS NPU 和八核 CPU(4×A72 + 4×A53),自己就能做一定的 LLM 推理。接上 RK1828 后,组合算力常被写成 6+20=26 TOPS。RK3572 是 4 TOPS,大核只有 2×A73 + 6×A53,单核和 NPU 都低于 RK3576。
在双芯架构里,LLM 已经完全在 RK1828 上,主控的 NPU 和 CPU 用来调度、预处理和轻量推理,RK3572 够用。这套组合的价值是成本:便宜的主控负责系统,算力预算放在协处理器上。入门级 AI 盒子、轻量智能终端,如果不需要 RK3576 那一档 CPU,又要端侧 LLM,可以走这条路径。更完整的三款主控对比见 RK3572 / RK3576 / RK3588 参数对比。
四、RKNN3 软件工具链与部署
4.1 SDK
瑞芯微为 RK1820/RK1828 配了 RKNN3 SDK。2026 年 3 月发布 V1.0.0 正式版,覆盖 PC 端开发套件、板端运行 API 和模型转换示例,支持 Android 和 Linux。
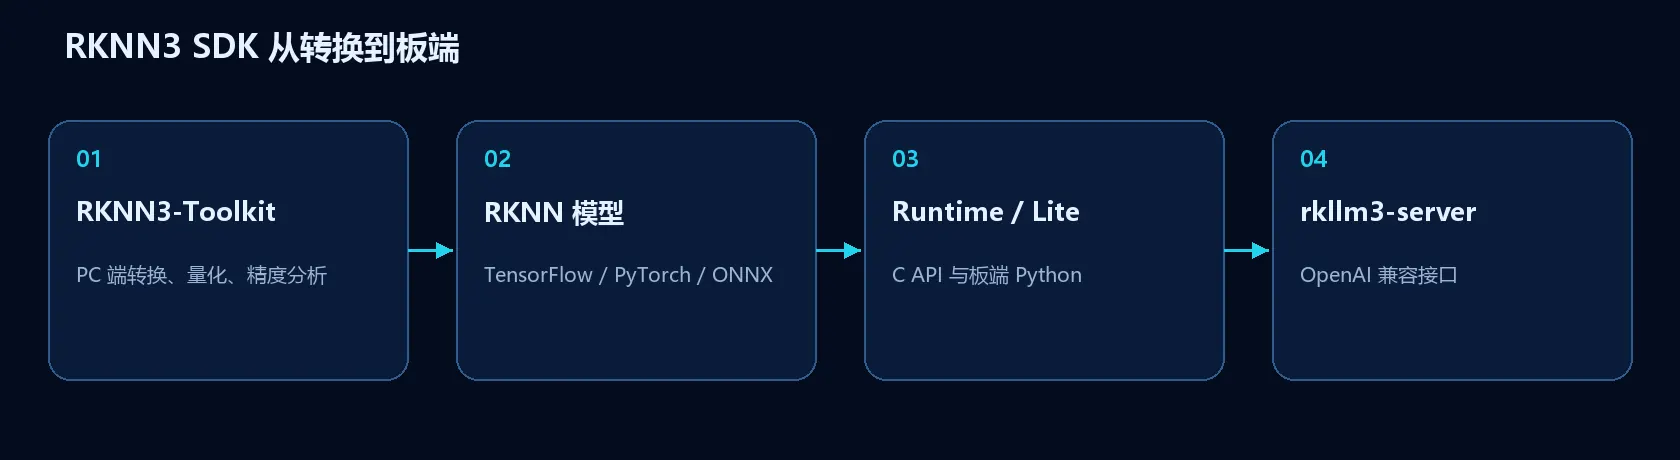
- RKNN3-Toolkit:PC 端模型转换、量化与精度分析
- RKNN3 Runtime:板端推理运行时,C API
- RKNN3-Toolkit Lite:板端 Python 轻量化工具包
- rkllm3-server:OpenAI 兼容的模型服务接口
转换流程是:在 PC 上用 RKNN3-Toolkit 把 TensorFlow、PyTorch、ONNX 模型转成 RKNN 并量化,再用 Runtime 或 Toolkit Lite 部署到板端。
4.2 协处理器模式怎么通信
协处理器模式下,主控和 RK1828 的通信由 rknn3_transfer_proxy 管理。主控经 PCIe 把推理请求和输入送到协处理器,算完再把结果送回。可以用 rknn3_transfer_proxy devices 确认识别是否成功,设备 ID 类似 0000:01:00.0 b98e6c51 PCIE。
RKNN3 SDK V1.0.0 支持数据传输和推理并行:这一轮还在算,下一批输入可以先准备,减少 PCIe 等待。
4.3 多卡级联
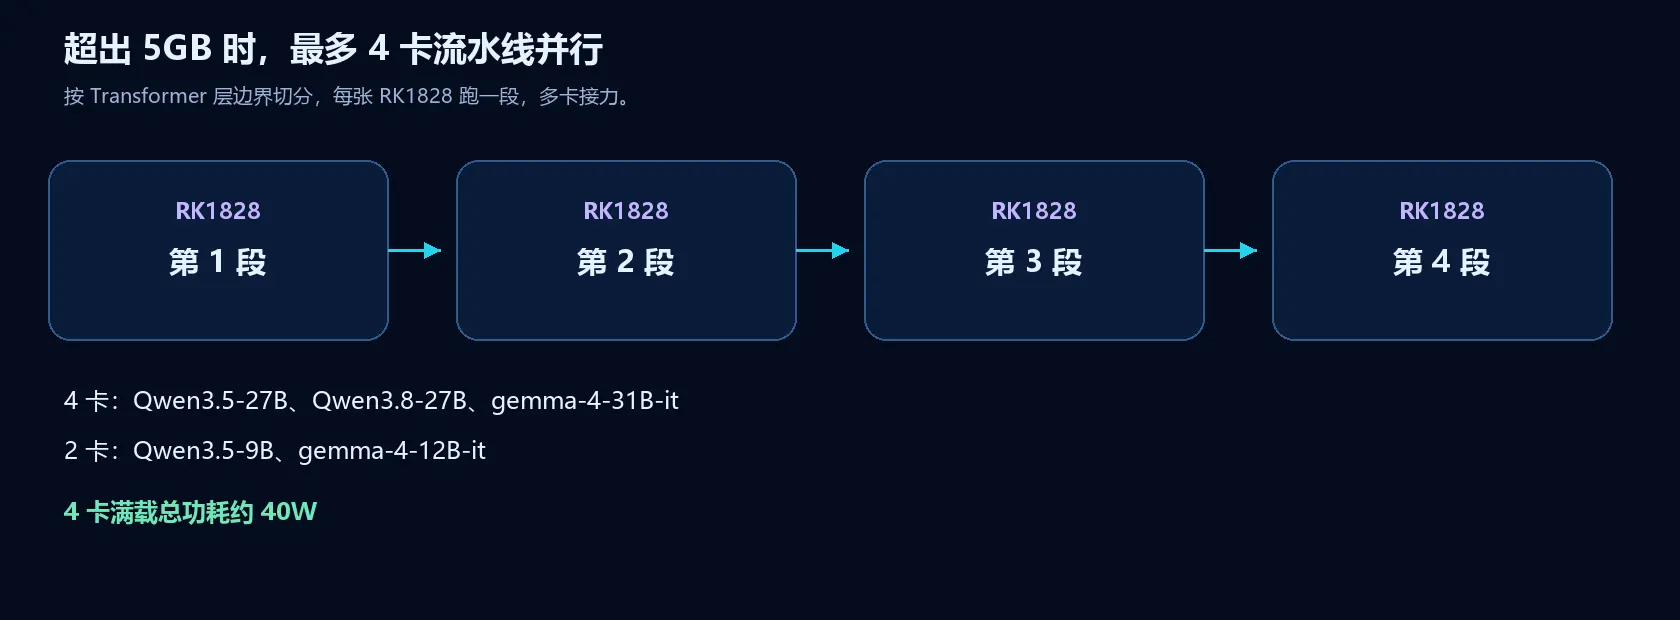
更大的模型可以 4 卡 PCIe 级联。RKNN3 SDK 用流水线并行:在 Transformer 层边界把模型切开,每张 RK1828 跑一段,多卡接力完成整段推理。
已经适配的方案包括:4 卡运行 Qwen3.5-27B、Qwen3.8-27B、gemma-4-31B-it;2 卡运行 Qwen3.5-9B、gemma-4-12B-it。4 卡满载总功耗控制在 40W 左右。
五、性能实测数据
5.1 LLM 推理
测试条件:RKNN3 SDK V1.0.0,Input Tokens = 128,New Tokens = 128。
| 模型 | 参数量 | TTFT(首 Token) | Decode |
|---|---|---|---|
| Qwen2.5-0.5B | 0.5B | 21.89 ms | 215.86 tokens/s |
| Qwen2.5-3B | 3B | — | 102.01 tokens/s |
| Qwen2.5-7B(W4A16) | 7B | 161 ms | 59 tokens/s |
| Qwen3-8B | 8B | — | 61.11 tokens/s |
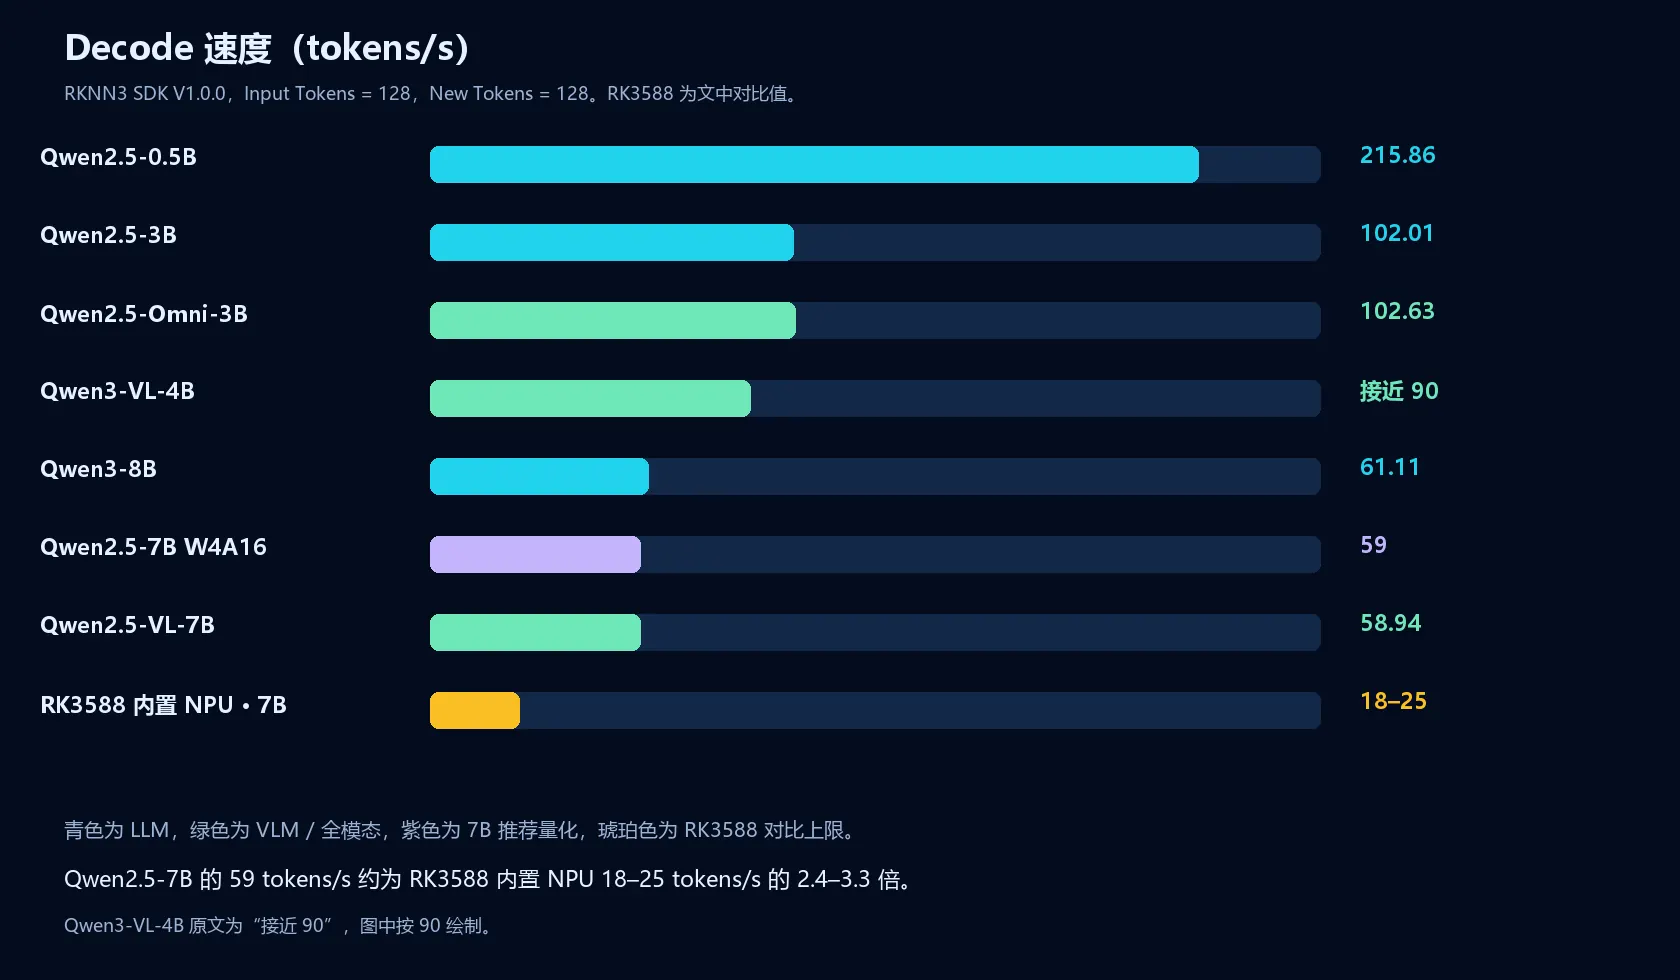
3B 档 Decode 超过 100 tokens/s,Qwen2.5-3B 为 102.01。0.5B 的 TTFT 只有 21.89 ms,TPOT 4.63 ms,Decode 215.86 tokens/s。7B 在 W4A16 下 TTFT 约 161 ms,生成约 59 tokens/s,日常聊天、摘要和指令调用可用。纯 RK3588 内置 NPU 跑 7B 约 18–25 tokens/s,RK1828 单卡大约是它的 2.4–3.3 倍。
5.2 VLM 与多模态
Qwen3-VL-4B 的 LLM Decode 接近 90 tokens/s。Qwen2.5-VL-7B 的 TTFT 约 161 ms,生成约 58.94 tokens/s。Qwen2.5-Omni-3B 在 RK1828 上做音视觉加语言的全链路推理,解码 102.63 tokens/s;392×392 视觉分辨率下耗时稳定,音频推理 98.91 ms。
5.3 CNN 视觉模型
YOLOv5s 在 RK1828 上的推理耗时稳定在 31 ms 以内,CPU 占用低。RKNN3 SDK 还优化了多 batch、多核推理,多核模式下帧率可以成倍提高,适合智能监控和工业检测。
六、典型应用案例
Violoop:屏幕感知智能体
这台设备用的是 RK3576 主控 + RK1828,不是 RK3572。它在 Kickstarter 上 20 小时内众筹突破 100 万美元。RK3576 负责系统、采屏和编排,RK1828 的 20 TOPS 做本地大模型。设备通过 HDMI 和 USB 接在计算机与显示器之间,读屏、理解、等用户确认后经 USB-HID 跨应用执行。
离线办公智能体
瑞芯微与亿次网联的离线本地 AI 办公智能体搭载 RK1828,双芯架构可支撑最高 27B 稠密模型。模型、文件和对话留在本地,可对接既有协同文档、私有网盘和 OA,已在部分省份部署。
车载与机器人。基于 RK3576M + RK1828 的车载 AI BOX 搭载 Qwen3.5-Omni,做车内语音、视觉和传感的本地融合,数据留在终端。机器人侧,RK182X 已能跑理解图形界面的智能体,无唤醒词本地交互,并跨应用、跨系统操作。
七、部署要点与工程约束
7.1 内存边界
单卡 5GB 是硬边界。W4A16 的 7B 可以放进这 5GB;再大就要多卡,最多 4 卡,4 卡对应 27B–31B。选型时先定内存预算,避免推理时临时分片。
7.2 散热
M.2 形态在被动散热下可以稳定运行,典型约 10W,动态调频稳态约 53°C。长时间多轮对话或高并发视觉推理,建议留风道或加小风扇。
7.3 PCIe 链路
RK3572 三路 PCIe 2.1,每路 1 Lane。一张 RK1828 占一路,剩下的可以接 NVMe 或 Wi-Fi。多卡前要确认通道够。PCIe0 与 SATA0 存在复用,原理图阶段就要定。
7.4 软件生态
RKNN3 SDK 已适配 Qwen2.5、Qwen3、Qwen3.5、Gemma4、DeepSeek,并支持 mRoPE、Function Call。自研模型要用 RKNN3-Toolkit 做量化和算子转换,选型时先验证算子能不能过。
八、架构总结
这套架构可以用一句话收住:用主控保证系统确定性,用协处理器保证推理确定性。
RK3572 的 4 TOPS 和 2×A73 + 6×A53,在双芯里是稳定后台。采屏、外设、编排、预处理是脉冲式的、可预期的。RK1828 的 20 TOPS 和 1 TB/s 片上带宽是持续推理引擎,负载长、吃带宽。两类负载从物理上分开之后,延迟抖动会小下来,智能体不再被主控的日常任务拖住。
从 2026 年的产品节奏看,Violoop、车载 AI BOX、离线办公智能体说明“主控 + 协处理器”已经在落地。瑞芯微把这条路线当作长期芯片方向,RK182X 用 3D 堆叠 DRAM 解决带宽。需要端侧 LLM,又受成本、功耗或散热限制时,RK3572 + RK1828 是一条把算力、能效和系统响应分开处理的工程路径。