 智慧云天
首页 / 行业资讯 / LocateAnything 深度技术剖析:并行框解码的原理、边界,以及与 YOLO 在工程车辆检测中的选型对比
行业资讯
LocateAnything 深度技术剖析:并行框解码的原理、边界,以及与 YOLO 在工程车辆检测中的选型对比
英伟达NVIDIA 于 2026 年开源的 LocateAnything-3B 以并行框解码(Parallel Box Decoding, PBD)将视觉语言模型的定位吞吐量提升至 H100 上 12.7 BPS,在 LVIS、ScreenSpot-Pro 等基准上刷新 SOTA。然而,"比 YOLO 快 10 倍"的流行表述是对其速度语境的误读。本文从自回归瓶颈出发,拆解 PBD 的原子解码机制、混合推理模式与消费级硬件上的真实表现,并与 YOLO 系列在延迟、部署门槛、范式定位三个维度做结构化对比,最终落到工地重型工程车辆检测场景,给出"YOLO 为基座、LocateAnything 为语义旁路"的分层选型框架。
英伟达NVIDIA 于 2026 年开源的 LocateAnything-3B 以并行框解码(Parallel Box Decoding, PBD)将视觉语言模型的定位吞吐量提升至 H100 上 12.7 BPS,在 LVIS、ScreenSpot-Pro 等基准上刷新 SOTA。然而,"比 YOLO 快 10 倍"的流行表述是对其速度语境的误读。本文从自回归瓶颈出发,拆解 PBD 的原子解码机制、混合推理模式与消费级硬件上的真实表现,并与 YOLO 系列在延迟、部署门槛、范式定位三个维度做结构化对比,最终落到工地重型工程车辆检测场景,给出"YOLO 为基座、LocateAnything 为语义旁路"的分层选型框架。
一、LocateAnything 要解决的核心问题:坐标 token 的自回归瓶颈
1.1 传统 VLM 定位的串行化困局
视觉语言模型做目标检测的标准做法,是把一个二维边界框 (x₁, y₁, x₂, y₂) 序列化为多个一维坐标 token,交给语言解码器逐个自回归生成。检测一个物体需要 4 步解码,检测 100 个物体则需要 400 步;自回归的严格时序依赖成为推理速度的硬约束。
更隐蔽的代价在几何一致性上。四个坐标本应是一个耦合的整体,但逐 token 独立生成意味着模型在输出 x₁ 时并不"知道" x₂ 最终会落在哪里,容易产生畸形框和坐标偏移,尤其在高 IoU 阈值下精度损失显著。
1.2 PBD 的破局思路:把框当作原子单元
LocateAnything 的核心创新 PBD 采取的路线是:每个边界框(或点)被视为一个定长原子单元,在单次并行步骤中同时预测完整的坐标集,而非将坐标 token 任意切块后串行输出。这一设计同时解决两个问题:并行化解码释放吞吐,原子性保证框内几何连贯。
需要注意,PBD 并非无条件替代自回归。官方设计了混合推理模式:默认走 Fast Mode(多 token 预测,MTP)获得最大吞吐,但当并行输出出现格式异常或空间歧义时,无缝回退到 Slow Mode(下一 token 预测,NTP)逐 token 解码以保证稳定性。这一"快路径 + 安全网"的设计,是 PBD 能够在实际部署中既提速又不牺牲可靠性的关键工程决策。
二、模型架构与训练数据
LocateAnything-3B 的总参数量约 3B,架构由三部分组成:视觉编码器 MoonViT-SO-400M(原生分辨率最高约 2.5K,保留细粒度空间细节)、语言解码器 Qwen2.5-3B-Instruct,以及连接二者的两层 MLP 投影器。代码以 Apache 2.0 许可开源,权重采用 NVIDIA 非商业研究许可。
训练数据方面,LocateAnything-Data 包含 138M 语言查询、785M 边界框,覆盖通用目标检测、GUI 元素定位、指代表达理解、OCR 文字定位和点级定位等任务,数据规模与多样性是其在开放词汇和高 IoU 场景下取得优势的重要支撑。
在任务覆盖上,LocateAnything 是一个统一框架:开放词汇/长尾目标检测、密集多目标检测、短语与复杂指代定位、GUI grounding、OCR 与文档布局定位、点级定位,均在同一模型内完成。这种"一个模型、多种定位任务"的设计,使其定位更接近通用视觉定位引擎,而非窄域检测器。
三、性能真相:SOTA 精度与"速度"的语境
3.1 精度:高 IoU 阈值下的显著优势
在 H100 上,LocateAnything-3B 达到 12.7 BPS,约为 Qwen3-VL 的 10 倍、Rex-Omni 的约 2.5 倍。精度侧的关键数据如表 1 所示。
| 基准 | 指标 | LocateAnything-3B | Rex-Omni-3B | Qwen3-VL-4B |
|---|---|---|---|---|
| LVIS | F1@Mean | 50.7 | 46.9 | 43.5 |
| LVIS | F1@0.95 | 31.1 | 20.7 | 20.0 |
| COCO | F1@Mean | 54.7 | 52.9 | 46.1 |
| M6Doc | F1@Mean | 70.1 | 55.6* | — |
| ScreenSpot-Pro | Avg | 60.3 | — | — |
表 1 LocateAnything 与同类 VLM 定位模型的关键基准对比(* M6Doc 的 Rex-Omni 对照值依原文 +14.5 的增益反推)
最值得注意的指标是 LVIS F1@0.95:LocateAnything 达到 31.1,相对 Rex-Omni 的 20.7 提升超过 50%。这直接验证了 PBD 原子解码对框几何一致性的改善——在严格要求高 IoU 的场景下,逐 token 解码的坐标漂移被结构性抑制。
3.2 "快"的边界:消费级硬件上的真实延迟
12.7 BPS 是在 H100 数据中心 GPU 上、与同类 VLM grounding 模型对比的语境下成立的。一旦离开 H100,图景迅速变化。
在 RTX 5090 32GB 上(bf16、SDPA fallback、无 flash-attn),PBD 相对自回归仍带来约 2.1–2.2 倍的框吞吐提升,验证了并行解码的加速并非完全依赖专用栈。但两个硬约束随之暴露:
第一,显存。正常图像推理占用约 7.75 GB;官方处理器允许每图 25,600 个 ViT patch,在无 flash-attn 的 SDPA 路径下,一张 6016×3384 截图会产生约 40.6 GB 的注意力分配,H100 80GB 可吸收,消费级卡无法承载,必须降采样至 12,288 patch 以下才能在 32GB 内运行。
第二,速度量级。在 Apple Silicon M2 8GB 上,YOLO26n 单帧中位延迟约 17.5 ms,而 LocateAnything 处理一条完整指代关系句需要 10.6 秒,两者相差约三个数量级;LocateAnything 的内存在该场景下逼近 8GB 上限。
此外,官方发布的权重开箱不支持视觉提示推理,默认解码循环对 batch 的支持也有限制,工程化便利性与 YOLO 的成熟生态存在明显距离。
结论很清晰:LocateAnything 的"快"是 VLM 定位赛道内部的相对快,不是工业级实时检测意义上的快。它与 YOLO 不在同一个速度坐标系中。
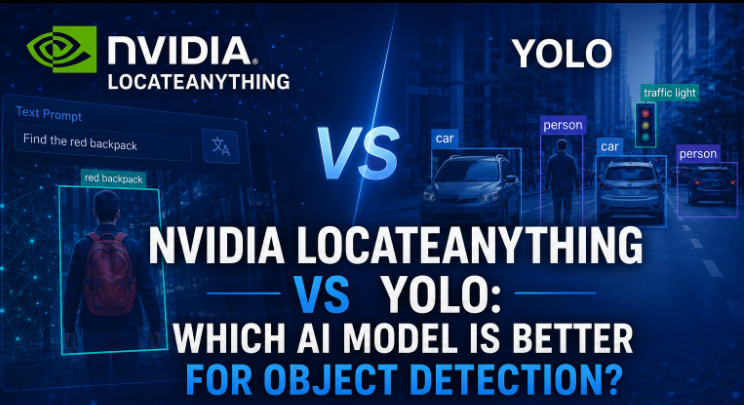
四、与 YOLO 的结构化对比
| 维度 | LocateAnything-3B | YOLO(v8/v11/v26) |
|---|---|---|
| 检测范式 | 开放词汇、语言驱动 | 封闭集、预定义类别 |
| 输入 | 图像 + 自然语言查询 | 仅图像 |
| 参数规模 | ~3B | 2.5M–59M(n/s/m/l/x) |
| 数据中心 GPU 延迟 | 12.7 BPS(H100) | YOLO26n FP16 约 17.5 ms/帧(消费级) |
| 边缘级硬件延迟 | 秒级(M2 8GB 实测 10.6 s/复杂查询) | 毫秒级(17.5 ms 中位) |
| 显存/内存门槛 | 官方高分辨率需大显存;正常图像 ~7.75 GB | 极低,n 级可在低功耗边缘运行 |
| 工地场景生态 | 新兴,部署方案仍在完善 | 极高,大量落地验证与优化经验 |
| 类别变更 | 自然语言描述即可,无需重训 | 需重新标注 + 训练 |
| 密集/高 IoU 定位 | 优势明显(LVIS F1@0.95 31.1) | 成熟,但高 IoU 细粒度弱于 VLM |
| 商用许可 | 权重 NVIDIA 非商业研究许可 | AGPL/企业许可,商用路径清晰 |
表 2 LocateAnything 与 YOLO 的多维度结构化对比
表 2 的核心信息可以凝练为一句话:YOLO 的"快"是工业级实时检测的快;LocateAnything 的"快"是视觉语言模型内部、在数据中心 GPU 上、相对同类 grounding 模型的快。两者相差 1–3 个数量级的延迟鸿沟,不会因为 PBD 的出现而被抹平,因为它们的架构复杂度、参数规模和设计目标本就属于不同的工程问题。
五、工地重型工程车辆检测:选型建议
5.1 先拆分场景,而非二选一
工地重型车辆检测在实践中包含两类性质不同的子任务:
子任务 A:实时安全监控与调度(主流,占 90% 以上需求)。检测挖掘机、渣土车、泵车、汽车吊等是否进入危险区域、是否违规作业。要求 7×24 小时视频流处理,延迟通常在几十到几百毫秒量级,部署载体多为工地边缘盒子、NVR 或低功耗 GPU,算力和内存有限。类别在项目启动时基本确定。
子任务 B:复杂语义检索与开放场景复核(辅助)。例如"找出正在吊装钢筋的汽车吊""有没有未覆盖篷布的渣土车驶出"。类别无法事先穷举,依赖组合语义和长尾描述,可以接受秒级响应,通常用于事后检索、巡检复核或低频分析。
5.2 分场景选型矩阵
| 场景 | 推荐方案 | 依据 |
|---|---|---|
| 实时安全监控(主流) | YOLO(v8s/m、v11、v26 轻量档) | 毫秒级延迟;YOLO26 在三类工地车辆上 mAP@0.5 达 0.938,其中轮式装载机 0.978、挖掘机 0.914、自卸车 0.923 |
| 边缘设备 / 低功耗盒子 | YOLO | LocateAnything 正常推理约 7.75 GB 显存,边缘实时吞吐不足;YOLO nano 级可在低瓦数硬件实时运行 |
| 类别固定、追求性价比 | YOLO | 迁移学习 + 预训练权重,工程链路最短,工地场景已有大量成熟方案 |
| 自然语言长尾/组合语义检索 | LocateAnything 作为补充 | 开放词汇与复杂指代能力是 YOLO 无法替代的 |
| 离线事后视频分析(有 GPU 服务器) | LocateAnything 可用 | 秒级延迟在事后分析中可接受,换取开放词汇分析灵活性 |
| 商业闭源产品化 | 优先 YOLO | LocateAnything 权重为非商业研究许可,商用需评估授权 |
表 3 工地重型工程车辆检测的分场景选型矩阵
5.3 推荐落地路线:YOLO 为基座,LocateAnything 为语义旁路
第一阶段(立即可用)。以 YOLO 作为实时检测基座,选择 YOLOv8s/m 或 YOLO26 的轻量档,针对工地车辆类别做迁移学习,配合 TensorRT 在边缘 GPU 上部署,承担视频流的毫秒级告警。工地场景的工程实践已经证明,YOLO 系列在 200 ms 以内的端到端延迟和 0.9+ mAP@0.5 的精度水平上具备可靠的成熟度。
第二阶段(按需增强)。在已有 GPU 服务器的前提下,将 LocateAnything 以低频、异步方式接入,处理 YOLO 覆盖不到的开放式查询。典型用法是:YOLO 保证每秒多帧的实时检测与告警;LocateAnything 对关键帧做语义复核(如"画面中是否存在未覆盖篷布的渣土车"),作为第二引擎按需调用,而非替代 YOLO 承担主链路。
一个值得同步评估的中间选项是 YOLOE。它在保留 YOLO 级实时性的同时提供一定的开放词汇能力,适合"需要动态词表但无法承受 3B VLM 延迟"的场景。Apple Silicon 上的对比实验也提示:YOLO26n 适合持续运行的固定类别感知,YOLOE 是实时检测与大 VLM 之间实用的中间层,而 LocateAnything 在复杂指代上能力最强但速度和内存成本显著更高。
六、结论
LocateAnything 的技术贡献是真实的:PBD 从解码机制层面修复了 VLM 定位中长期存在的"串行速度瓶颈 + 几何一致性损失"这一对矛盾,混合推理在提速与稳定之间给出了可操作的工程折中,高 IoU 基准上的领先幅度也证明了原子解码的实际收益。但它的"快"有明确的坐标系——数据中心 GPU、VLM 赛道内部、非实时视频流场景。
工地重型工程车辆检测的第一优先级始终是实时性、边缘可部署性和长期运行可靠性。在这个坐标系里,YOLO 仍然是当前最理性、风险最低的主检测器。LocateAnything 的正确位置,是用开放词汇和复杂指代能力补足 YOLO 在长尾语义查询上的结构性盲区——作为语义旁路按需调用,而非作为实时检测的替代方案。
选型的本质不是比较两个模型的绝对优劣,而是识别它们各自适用的工程问题边界,然后让它们在同一个系统中各司其职。
常见问题
LocateAnything 比 YOLO 快吗?
在实时检测的意义上并不快。LocateAnything 在 H100 上达到 12.7 BPS,这是相对其他视觉语言定位模型(约为 Qwen3-VL 的 10 倍)而言的快。YOLO 在消费级和边缘硬件上是毫秒级延迟——例如 YOLO26n 约 17.5 ms/帧,而 LocateAnything 在 M2 8GB 上处理一条复杂查询约需 10.6 秒。两者相差 1–3 个数量级,不在同一速度坐标系中。
工地重型工程车辆检测、打架、跌倒应该用 YOLO 还是 LocateAnything?
实时安全监控与调度用 YOLO 作主检测器——毫秒级延迟、低内存、工地生态成熟。开放式查询(如"找出未覆盖篷布的渣土车""正在吊装钢筋的汽车吊")用 LocateAnything 作按需语义旁路,因为 YOLO 的固定类别集无法覆盖。推荐架构:YOLO 承担实时主链路 + LocateAnything 异步语义复核。
LocateAnything 能部署在边缘设备上吗?
有很大限制。正常推理约需 7.75 GB 内存,高分辨率图像在无 flash-attn 的 SDPA 路径下需求更高。M2 8GB 上复杂查询约 10.6 秒,且内存逼近上限。它不适合边缘实时视频流;YOLO nano 级模型仍是边缘部署的务实选择。
什么是并行框解码(PBD)?
PBD 是 LocateAnything 的解码机制,把每个边界框当作定长原子单元,在单次并行步骤中预测全部四个坐标,而非自回归地序列化坐标 token。它同时提升吞吐并保持框内几何一致性,并配有混合模式,在并行输出不稳定时回退到逐 token 解码。
LocateAnything 的许可证允许商用吗?
代码为 Apache 2.0,但模型权重采用 NVIDIA 非商业研究许可。商业产品化需评估授权路径;YOLO 的 AGPL/企业许可提供了更清晰的商用通道。